
A generatív mesterséges intelligencia (MI) négy különálló rétegre osztja az ipari robotikát: (1) LLM-alapú kód- és mozgásszkript-generálás a meglévő vezérlőnyelvekhez; (2) látás-nyelv-művelet (VLA) alapmodellek a teljes körű manipulációhoz explicit programozás nélkül; (3) generatív szimulációs platformok, amelyek nagy léptékben állítanak elő szintetikus betanítási adatokat; és (4) mesterséges intelligenciával kiegészített offline programozás természetes nyelvű tanítópultokkal. 2026-tól az 1. és 4. réteg mérhető léptékben van gyártásban; a 2. és 3. réteg továbbra is kísérleti szakaszban van.
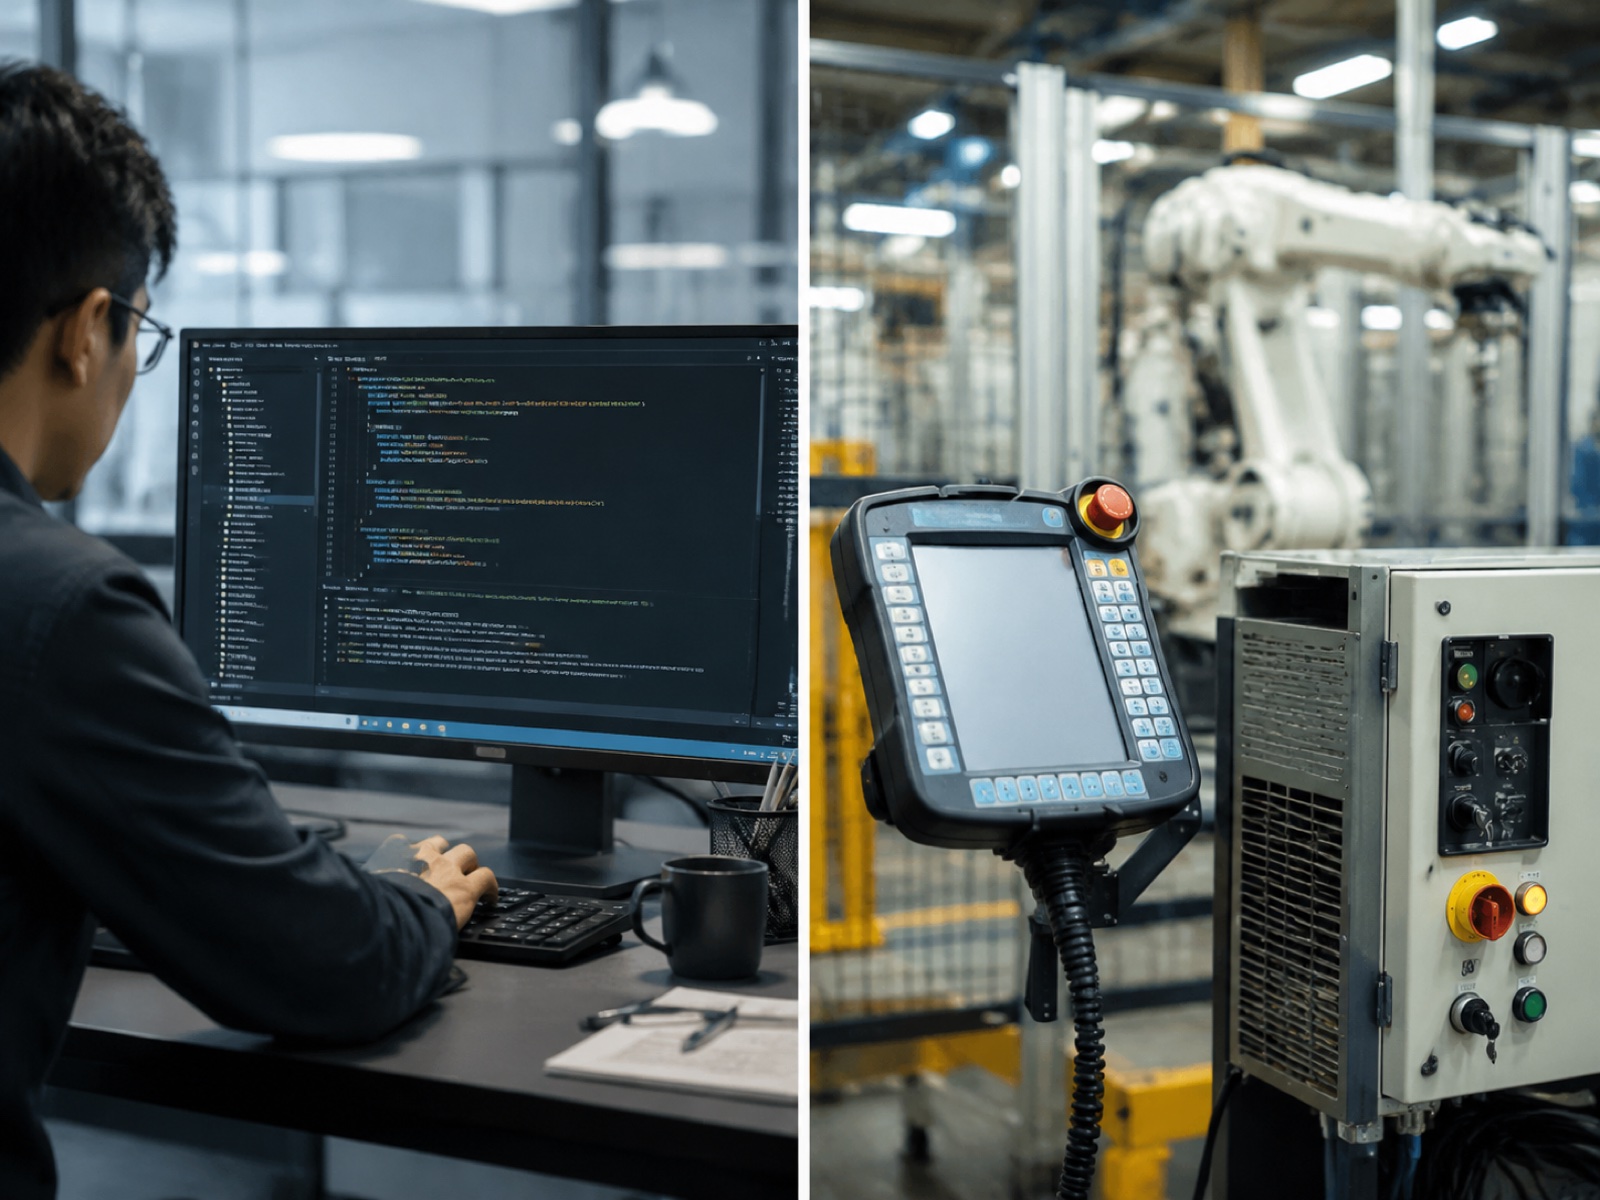
1. réteg: LLM kód és mozgásszkript generálása
A generatív mesterséges intelligencia ipari robotikában történő legközvetlenebb alkalmazása nem igényel új hardvert vagy eltérő robotarchitektúrát. A mesterséges intelligencia helyettesíti, vagy legalábbis felgyorsítja a robotprogramok vezérlőspecifikus nyelveken történő írásának folyamatát azáltal, hogy nagyméretű, robotprogramozási szintaxist tartalmazó kódkorpuszokon betanított nyelvi modelleket használ.
Az ipari robotvezérlők mindegyike saját, saját fejlesztésű nyelvet használ: a FANUC Teach Pendant (TP) kód, az ABB RAPID, a KUKA Robot Language (KRL) és az Universal Robots URScript a négy legszélesebb körben elterjedt az autóiparban és az általános gyártásban. Egy ilyen nyelvtani nyelvtannal rendelkező LLM (jogi mesterképzés) természetes nyelvi utasításokból programokat generálhat, fejezhet be és hibakereshet, nagyjából ugyanúgy, ahogy a GitHub Copilot befejezi a Pythont vagy a JavaScriptet. Az analógia szándékos: a korai LLM robotikai eszközöket kifejezetten a „GitHub Copilot for robot programozás”-ként pozicionálják.
Az ABB jutott a legmesszebbre az OEM-piacon a RobotStudio-ba, az OLP platformjába ágyazott, gyártásorientált MI-támogatási funkcióval. Az ABB belső LLM-integrációja lehetővé teszi a mérnökök számára, hogy egy pályacélt egyszerű nyelven írjanak le, például: „pisztolypálya generálása a konzol felső karimája mentén 60 fokos pisztolyszöggel és 0.4 m/s haladási sebességgel”, és RAPID-kódot kapjanak kimenetként. A mérnök felülvizsgálja, módosítja és validálja; az LLM lerövidíti a rajzolási fázist a mérnök kiiktatása helyett.
A Microsoft Research 2024-ben publikált Robotics Copilot projektje egy olyan architektúrát mutatott be, amelyben a természetes nyelvű készségleírásokat strukturált robotirányelvi kóddá alakítják egy LLM közbenső rétegen keresztül. A rendszer teljes egészében angol nyelven leírt felvételi és elhelyezési, valamint összeszerelési feladatokat kezelt, az LLM pedig a jelenet kontextusából következtette ki az objektumhivatkozásokat, ahelyett, hogy explicit koordináta-bevitelt igényelt volna. A kutatás keretrendszere (készségek természetes nyelven keresztül) befolyásolta a későbbi kereskedelmi integrációkat.
A FANUC nulla leállást gátló (ZDT) platformja egy LLM asszisztens réteggel bővült az anomáliák magyarázatához és a korrekciós kódjavaslatokhoz, amely nem programíró eszközként, hanem a meglévő TP kódkönyvtárak hibakeresési és karbantartási gyorsítójaként pozicionálja azt.
Az autóipari és általános gyártási környezetekben végzett korai LLM kódgenerálási kísérleti projektek iparági megfigyelései szerint az új robotrutinok programozási ideje 25–40%-kal csökken, ha az LLM kódkiegészítő eszközöket integrálják a szabványos OLP munkafolyamatokba, a legnagyobb előnyökkel az ismétlődő, paraméterezhető programok, például a pick-and-place szekvenciák és a szabványosított hegesztési menetek esetében. A nyereség jelentősen csökken az összetett, többtengelyes koordinált mozgások esetében, ahol a mérnöki áttekintési idő dominál a kódírási idővel szemben.
A korlátok valósak. Az LLM-ek szintaktikailag helyes RAPID vagy TP kódot generálhatnak, amely kinematikailag érvénytelen: olyan útvonalak, amelyek a szerszámot a robot elérhető munkaterületén kívülre helyezik, vagy amelyek csuklószingularitásokat generálnak a pálya közepén. A generált kód ugyanolyan elérhetőségi és ütközésérzékelési validációs követelményeket igényel, mint a manuálisan írt OLP programok. Az LLM lerövidíti a szerzői időt; nem helyettesíti az ellenőrzést. Ez egy strukturális korlátozás, amíg a formális ellenőrző eszközöket közvetlenül nem integrálják a generálási folyamatba, ami 2026-tól aktív kutatási terület.
A mesterséges intelligencia által generált kódgenerálás és a szélesebb OLP szoftvercsomag integrálásának részletesebb ismertetéséhez tekintse meg a kapcsolódó cikkünket. Robothegesztés Offline programozás, szimuláció és digitális ikermodell (2026).
2. réteg: VLA alapmodellek a teljes körű manipulációhoz
A látás-nyelv-cselekvés modellek alapvetően eltérő megközelítést képviselnek a robotprogramozásban. Ahelyett, hogy egy determinisztikus vezérlőhöz generálna kódot, a VLA modell a kamera képeit és egy természetes nyelvű utasítást vesz bemenetként, és közvetlenül kimenetként jeleníti meg a robotműveleteket, egyetlen végponttól végpontig terjedő neurális hálózatként. Nincs külön úttervező, nincs explicit koordináta-specifikáció, nincs utófeldolgozó. A modell a betanítási eloszlásból kiindulva olyan módon általánosít új objektumokra és konfigurációkra, amire a kódalapú megközelítések nem képesek.
Kulcsfontosságú kutatási mérföldkövek
A VLA kutatási pályája jelentősen felgyorsult 2023 óta. Az RT-2 (Google DeepMind, 2023) kimutatta, hogy egy látásnyelven előre betanított gerinchálózatból inicializált modell képes emergent gondolkodást mutatni, olyan feladatok elvégzésére, amelyekre soha nem képezték ki explicit módon, a webes méretű adatokból tanult fogalmak kombinálásával. Ez precedenst teremtett a nagy alapmodellek robotpolitikai gerinchálózatként való használatára.
Az OpenVLA (Stanfordi Egyetem, 2024) egy teljesen nyílt súlyozású alternatívát kínált 7 milliárd paraméterrel, a Prismatic VLM architektúra alapján. Az OpenVLA Apache 2.0 licence és finomhangolható akadálymentesítése tette az elsődleges kutatási és korai ipari kísérleti alapjául azon laboratóriumok és integrátorok számára, amelyek nem fértek hozzá a Google saját számítási rendszeréhez.
A Physical Intelligence π0 (2024–25) modellje egy áramlásillesztő akciófejet vezetett be a diszkrét token osztályozás helyett, ami simább pályákat eredményezett, amelyek jobban megfelelnek a többlépcsős ügyességi feladatokhoz. A Figure AI Helix (2024–25), amelyet a BMW spartanburgi gyárában található Figure 02 humanoidon telepítettek, kétmodell-megközelítést alkalmaz: egy magas szintű VLM kezeli a jelenet megértését, míg egy alacsony szintű szenzorimotoros modell vezérlőfrekvencián fut, elválasztva a nyelvi érvelési ciklust a valós idejű vezérlőhuroktól.
A Google DeepMind Gemini Robotics (2025) projektje a Gemini multimodális modellcsaládot alkalmazza ügyességi manipulációs és 3D térbeli gondolkodási feladatokra. Az NVIDIA GR00T N1 és GR00T-Mimic (2025) egy humanoid-specifikus VLA-vermet alkotnak – a GR00T N1 súlyok nyilvánosan elérhetők, így ez az egyik első humanoid alapmodell, amely külső finomhangolásra elérhető. A kísérő GR00T-Mimic folyamatlánc szintetikus demonstrációs adatokat generál emberi videóból, részben kitöltve a teleoperációs adathiányt.
Az Open X-Embodiment adatkészlet, amelyet több mint 60 laboratórium 22 robottípuson keresztül állított össze, továbbra is a legjelentősebb intézmények közötti adatmegosztási erőfeszítés a területen. Az ilyen heterogén adatokon való betanítás javítja a robotok közötti általánosítást: az Open X-Embodimenten betanított szabályzat megbízhatóbban visz át adatokat az új robot hardverre, mint az egyetlen platformon betanított.
A Stanford 2025-ös mesterséges intelligencia indexe szerint a robottanulásról és az alapmodell-alapú robotvezérlésről szóló, lektorált tanulmányok száma több mint 60%-kal nőtt 2022 és 2024 között, meghaladva az alkalmazott mesterséges intelligencia bármely más részterületének növekedését. Az index megjegyzi, hogy az ipari telepítés a milliméter alatti pontosságot igénylő manipulációs feladatok esetében átlagosan 18-36 hónappal elmarad a kutatási publikációktól, ami tükrözi a demonstrációs megvalósíthatóság és a gyártási szintű megbízhatóság közötti szakadékot.
Ipari telepítési állapot
2026-tól kezdve a VLA ipari környezetben történő alkalmazása két alkalmazási kategóriára koncentrálódott, ahol a rugalmasság érve a legerősebb, és az alkalmi meghibásodások költsége kezelhető: nagy keverésű ládák komissiózása és rugalmas összeszerelés laza tűrésű feladatokhoz. A Covariant RFM-1 e-kereskedelmi teljesítési megoldása a leggyakrabban idézett kereskedelmi alkalmazás. Az AI Helix-szel rendelkező autóipari kísérleti programok jelentik a leglátványosabb nehézipari tesztesetet.
A hegesztés, a nagy teherbírású manipuláció és a precíziós összeszerelés kívül esik a jelenlegi VLA gyártási kereten. A neurális hálózati működtetőfejek sztochasztikus következtetési viselkedése olyan varianciát hoz létre, amely meghaladhatja a folyamattűréseket a 0.1 mm-nél kisebb ismétlési pontosságot igénylő alkalmazásokban. Kifejezetten a hegesztés esetében az ISO 3834 és az AWS D1.1 szabvány szerinti minősített hegesztési eljárás (WPS) nyomonkövethetőségi követelményei további akadályokat gördítenek a determinisztikus útvonal-végrehajtás valószínűségi irányelv-következtetéssel való helyettesítése elé.
Az EVST, amelynek termékfejlesztési ütemterve mostanra tartalmazza humanoid robotok, ügyes kezek az adatgyűjtéshez és négylábú robotok ipari robotjai és hegesztőrendszerei mellett ezen az átmeneten keresztül helyezkedik el. Adatgyűjtő, ügyes kézi platformja megoldja a demonstrációs adatok szűk keresztmetszetét, amelytől a VLA-képzés függ. Ez egy olyan terület, ahol a hardverberuházásnak most közvetlen hatása van az alapmodell minőségére. A megtestesült MI-architektúra és a VLA-modell mechanikájának hátteréről lásd: Megtestesült mesterséges intelligencia az ipari robotikában: Hogyan változtatják meg a VLA modellek a robotprogramozástAz ezeket a modelleket támogató adatgyűjtési infrastruktúra kontextusát lásd: Megtestesült mesterséges intelligencia adatgyűjtése: Teleoperáció és szimulációtól a valóságig (2026).
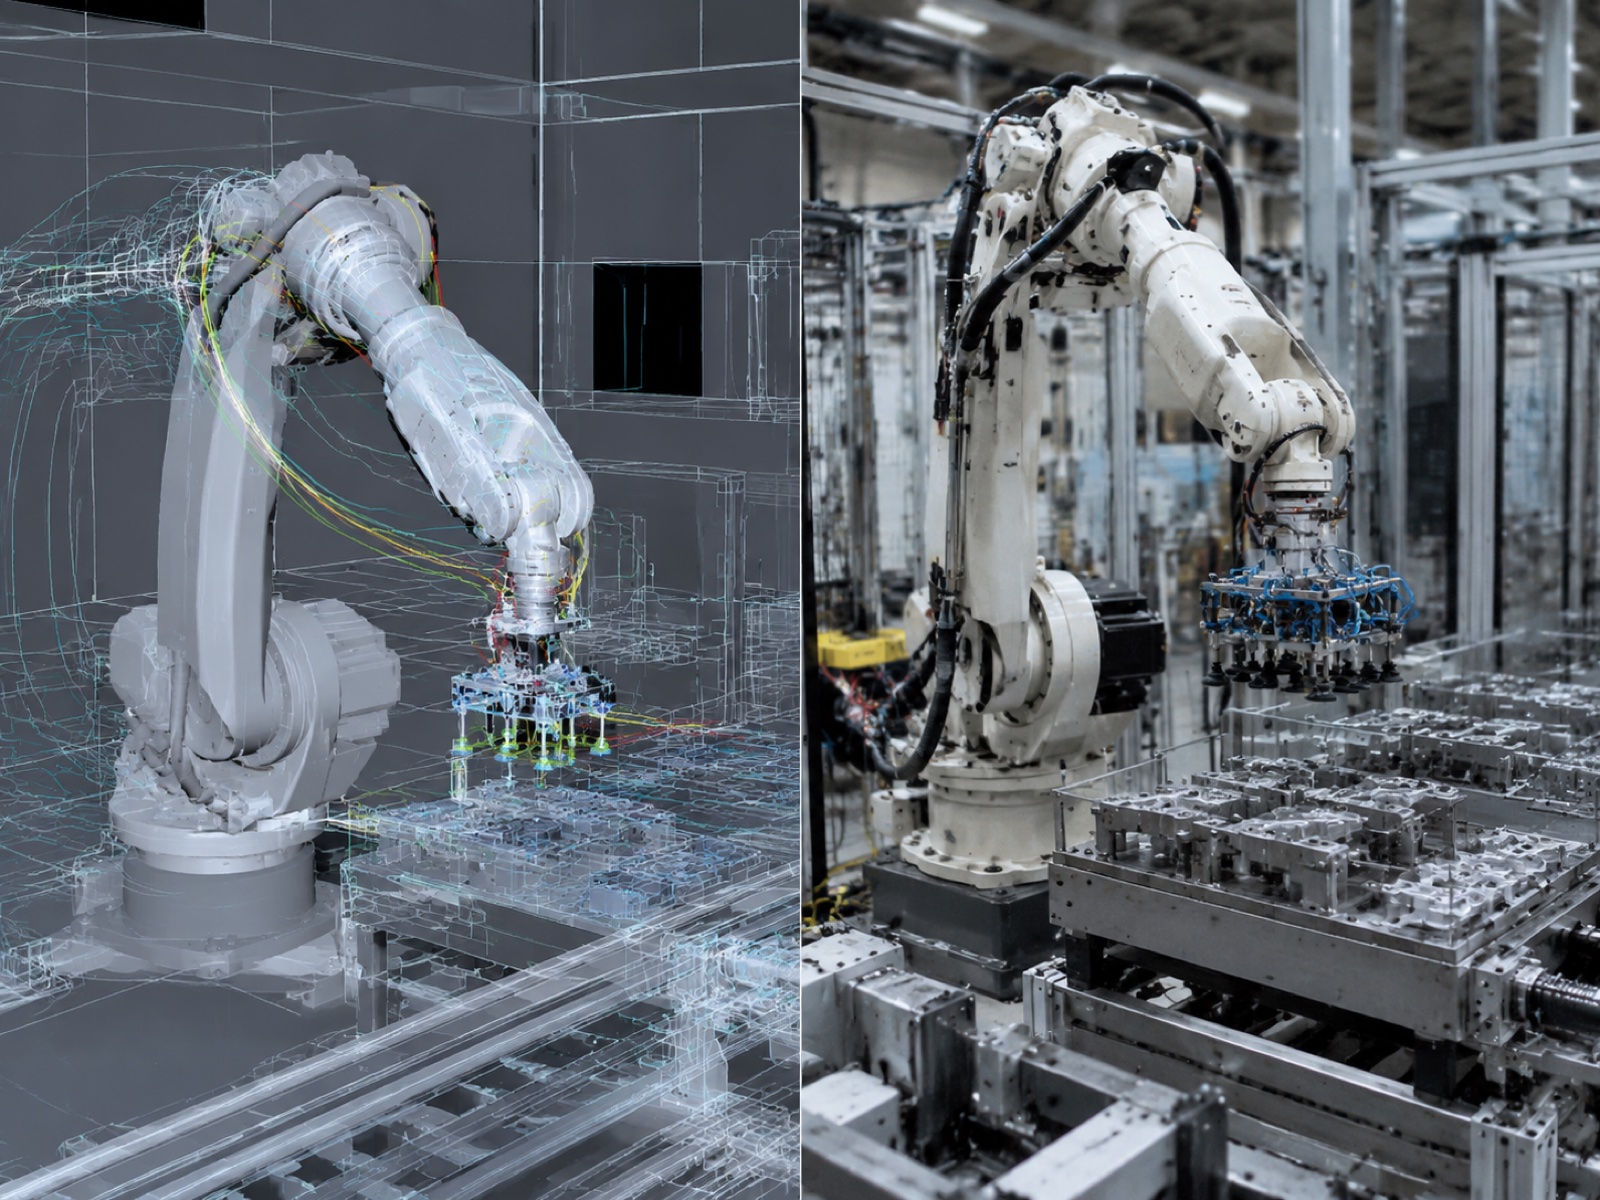
3. réteg: Generatív szimuláció és szintetikus betanítási adatok
A VLA modellekhez nagy léptékű demonstrációs adatokra van szükség. A fizikai teleoperáció – amikor egy ember egy haptikus interfészen keresztül irányít egy robotot, miközben a rendszer rögzíti az ízületek állapotát és a kamerafolyamokat – a legminőségibb adatforrás, de drága és lassú. Az iparági megfigyelések szerint egy használható demonstrációs adatkészlet összegyűjtése egy új manipulációs feladathoz feladatváltozatonként nagyjából 10–100 óra operátori időt vesz igénybe. A generatív szimuláció ezt a szűk keresztmetszetet úgy küszöböli ki, hogy szintetikus betanító adatokat generál szoftverben, a fizikai költségek töredékéért.
NVIDIA Cosmos és Isaac Sim 4.5
Az NVIDIA Cosmos World Foundation Models, amelyet a GR00T-vel együtt jelentettek be a GTC 2025-ön, fizikailag hihető oktatóvideókat generál szöveges vagy képes promptokból. A hagyományos szimulátoros renderelés helyett a Cosmos fotorealisztikus szintetikus videót készít, amely jobban megfelel a valós kamerakép statisztikáinak, csökkentve a szimulált és a valós kép közötti rés vizuális tartományeltolódási komponensét. Az NVIDIA Isaac Sim 4.5 biztosítja az alapul szolgáló fizikailag pontos szimulációs környezetet, amely párhuzamos környezeteket futtat az NVIDIA GPU infrastruktúráján, hogy a robotpálya-adatokat az alapmodell betanításához szükséges méretekben gyűjtse.
A fotorealisztikus szintetikus videók generálására szolgáló Cosmos és a párhuzamos, fizikán alapuló pályagörbe-gyűjtésre szolgáló Isaac Sim kombinációja az NVIDIA integrált válaszát alkotja a humanoid és ipari robot alapmodellek betanítási adatproblémájára.
Nyílt forráskódú és akadémiai generatív szimulátorok
A Genesis (Tsinghua Egyetem) egy nyílt forráskódú generatív szimulációs platform, amely differenciálható fizikát és generatív jelenetkompozíciót használ változatos képzési forgatókönyvek létrehozásához nagy áteresztőképességgel. A DreamGen videodiffúziós modelleket alkalmaz nyelvi leírásokon alapuló robotmanipulációs bemutatók létrehozására, lehetővé téve az adatkiegészítést további fizikai robotidő nélkül. A RoboCasa nagyméretű szimulációs benchmarkot biztosít háztartási és konyhai manipulációs feladatokhoz, különösen hasznos a humanoid robotok kétkezes ügyességi szituációkban történő betanításához.
A szimuláció és a valóság közötti szakadék: 2024–25-ös előrehaladás
A szimuláció és a valóság közötti különbség (a szabályzat teljesítményének csökkenése, amikor egy szimulációban betanított modellt fizikai roboton telepítenek) mérhetően szűkült 2023 és 2025 között három mechanizmus révén. A tartományrandomizálás (a textúrák, megvilágítás, tárgytömegek és súrlódási együtthatók véletlenszerű változtatása a szimulációs betanítás során) továbbra is a legszélesebb körben alkalmazott technika. A Cosmos és hasonló eszközök segítségével történő fotorealisztikus renderelés csökkenti a vizuális tartományeltolódást. A szintetikus pályákat kisebb mennyiségű valós teleoperációs adattal ötvöző hibrid adatfolyamatok pedig következetes teljesítményjavulást mutattak a tiszta szimulációhoz vagy a tiszta valós betanításhoz képest a közzétett benchmarkokban.
Az NVIDIA közzétett fejlesztői ökoszisztéma-adatai szerint 2026 elején több mint 700 ipari vállalat használta az NVIDIA Omniverse és az Isaac Sim szoftvereit digitális ikermodell, szimuláció és szintetikus adatgeneráló alkalmazásokhoz, a robotikai manipuláció és a mobil robotnavigáció pedig a legfontosabb alkalmazáskategóriák közé tartozott. Az NVIDIA által közzétett fejlesztői adaptációs adatok közelítő mutatót jelentenek arra vonatkozóan, hogy milyen ütemben kerül be a generatív szimulációs infrastruktúra az ipari munkafolyamatokba, bár a cellánkénti telepítési részleteket külön nem hozzák nyilvánosságra.
4. réteg: Természetes nyelvű OLP és mesterséges intelligenciával kiterjesztett teaching pendant
A 4. réteg a generatív mesterséges intelligenciát arra a pontra alkalmazza, ahol jelenleg a legtöbb gyári robotprogramozás történik: a betanító pultra, vagy annak szoftveres megfelelőjére egy OLP eszközben. Az 1. rétegtől való különbség a kontextus. Az 1. réteg általános célú kódot generál nyelvi leírásokból. A 4. réteg közvetlenül integrálódik egy adott folyamattal – hegesztéssel, festéssel, összeszereléssel –, és teljesen paraméterezett, folyamattudatos mozgásprogramokat generál a kezelői szintű természetes nyelvi bemenetekből, beleértve a folyamatparamétereket is, nem csak a geometriai útvonalakat.
A réteg értékét megragadó funkcionális példa: egy operátor utasítást ad egy hegesztőrendszernek, hogy „hegesszen egy 200 mm-es varratot az alkatrész alsó sarkánál”, és a rendszer visszaad egy teljes pisztolypályát a megközelítési szöggel, a haladási sebességgel, a szövési paraméterekkel és a folyamatkönyvtárból származó feszültségbeállításokkal, manuális útpont-meghatározás nélkül. Az operátor megerősíti és futtatja a folyamatot. Ez minőségileg eltér egy kódkiegészítő eszköztől, amely RAPID szintaxist generál egy geometriai leírásból; ez egy végponttól végpontig terjedő folyamatgeneráló rendszer.
Beszállítói implementációk
Az ABB RobotStudio integrált egy Copilot-stílusú természetes nyelvű asszisztenst, amely folyamatleírásokat fogad el, és strukturált robotprogramokat ad vissza ellenőrzésre. Az integráció a RAPID kódréteg felett helyezkedik el – az LLM indoklja a folyamatot, majd RAPID-ot generál –, ahelyett, hogy a mérnöknek közvetlenül meg kellene adnia a nyelvi szintű programot. Hegesztési alkalmazások esetén az asszisztens a RobotStudio hegesztő áramforrás-könyvtárára hivatkozva automatikusan kitöltheti az ívparamétereket.
A FANUC ZDT platformja természetes nyelvű diagnosztikai és korrekciós javaslati képességgel bővült, amely inkább kiegészíti, mintsem helyettesíti a TP kódírási munkafolyamatot. Az asszisztens egyszerű nyelven értelmezi a riasztási kódokat és a ciklusidő-anomáliákat, és paramétermódosításokat javasol, csökkentve a speciális programozókra való támaszkodást a rutinszerű karbantartási és hangolási feladatokhoz.
A hegesztésspecifikus alkalmazásokban a 4. rétegbeli képességeket alkalmazó OEM-ek között az EVST EVS-AI hegesztőrendszere integrálja a 3D-s látás automatikus szkennelését az automatizált útvonalgenerálással. Egy 3D-s kamera beolvassa a munkadarabot, kinyeri a hegesztési varrat geometriáját és az illesztési adatokat, és a rendszer egy teljes robothegesztési programot generál – útvonal, pisztoly orientáció, haladási sebesség és folyamatparaméterek – az RX hegesztési folyamatkönyvtárból merítve, amely előre betölti a tipikus illesztési geometriákat és a többmenetes szekvenciákat. A rendszer kiküszöböli a kézi betanítást a szénacél és alumínium szabványos sarok-, tompa- és átfedő illesztéseihez, és támogatja a kéthuzalos és többmenetes, többrétegű szekvenciákat a bonyolultabb alkatrészekhez. A CE, SGS és TUV harmadik fél általi tanúsítványok kiterjednek a minőségirányítású gyártási környezetekbe való integrációra. Ez az EVS-AI rendszert a 4. réteg gyártáskész végére helyezi, megkülönböztetve a más gyártóknál még validálás alatt álló LLM-első megközelítésektől. A rendszert is magában foglaló részletes szoftververem-összehasonlításért lásd: Robothegesztés Offline programozás, szimuláció és digitális ikermodell (2026).
Az IFR World Robotics adatai szerint az offline programozással vagy fejlett szimulációs szoftverrel szállított újonnan telepített hegesztőrobotok aránya a 2019-es körülbelül 25 százalékról 2024-re a becslések szerint 48 százalékra nőtt. A természetes nyelvű útvonalgeneráló interfészek hozzáadása a következő, az OLP feletti inkrementális képességi réteget jelenti, és a hegesztőrendszer-integrátorok korai alkalmazói adatai azt mutatják, hogy a mesterséges intelligencia által támogatott 3D szkennelési útvonal-rendszerek 80–95%-kal csökkentik az első darab programozási idejét a standard sarok- és tompavarrat-geometriákon a manuális OLP-módszerekhez képest.
Ipari vertikális felkészültség alkalmazásonként
A generatív mesterséges intelligencia használatára való felkészültség jelentősen eltér az iparágak között. A meghatározó tényezők a tűréshatárok, a szabályozási és minőségi nyomonkövethetőségi kötelezettségek, az adatok elérhetősége és a meghibásodás költsége.
Hegesztés
A mesterséges intelligencián alapuló látásminőség-ellenőrzés és a varratkövetés 2026-tól gyártási léptékben kerül bevezetésre a hegesztőcellákban – ezek 4. rétegbeli implementációk, amelyek strukturált fénykamerákat és mintaillesztési modelleket használnak, nem pedig VLA-következtetést. A teljes VLA-alapú hegesztési útvonalgenerálás, ahol egy neurális hálózati szabályzat vezérli a pisztoly mozgását determinisztikus folyamatkönyvtár nélkül, a becslések szerint 2026–2028-ra eléri a szabályozott gyártási bevezetést a szabványos szénacél geometriák esetében, feltéve, hogy a WPS nyomonkövethetőségi szabványait frissítik az MI által generált útvonalrekordok befogadására.
Összeszerelés és nagy mennyiségű gyártás
Az erővezérelt beillesztést és a LLM kényszerérvelést alkalmazó mesterséges intelligenciával vezérelt összeszerelés kísérleti alkalmazásban van az autóipari és szórakoztatóelektronikai gyártóknál. A 0.5 mm-nél nagyobb tűréshatárokkal rendelkező feladatok (kábelvezetés, bepattintható kapcsok, címkeelhelyezés) biztosítják a legerősebb rövid távú illeszkedést. A szűk tűrésű beillesztési feladatok (0.1 mm alatt) megtartják a klasszikus mozgásvezérlőket a precíziós működtetéshez, a VLA kezelési feladatkiválasztással és a durva pozicionálással a determinisztikus réteg felett.
Logisztika és kukák komissiózása
A nagy mennyiségben kevert tárolókból álló komissiózás és palettázás jelenti a legfejlettebb VLA telepítési vertikális területet 2026-ban. A Covariant RFM-1 és a Dexterity robot palettázó rendszerei a kísérleti fázisból a teljesítési központokban történő gyártásba léptek. Az új SKU-k tételenkénti programozás nélküli kezelésének kereskedelmi érve közvetlenül az alapmodell általánosításának köszönhető.
Nehéz- és 1. szintű autóipar
A nagy teherbírású gyártás (acélszerkezet, sajtolósori karbantartás, karosszériagyártás) és az 1. szintű autóipari karosszériaműhelyek továbbra is determinisztikus vezérlőket használnak. Az IATF16949 folyamatirányítási követelményei, az auditnapló-kötelezettségek és a nem tervezett állásidők tőkeköltsége miatt a sztochasztikus MI-következtetés 2026-ban nagy léptékben kereskedelmileg nem életképes. Ezek a környezetek elsősorban az 1. rétegen (kódgenerálás OLP-gyorsításhoz) és a 3. rétegen (szimulációs adatgenerálás) keresztül fogják bevezetni a generatív MI-t, mielőtt bármilyen 2. rétegbeli VLA-telepítést végeznének.
A McKinsey Global Institute 2025-ös, a mesterséges intelligenciával működő ipari műveletekről szóló jelentése szerint a szigorú minőségtanúsítási követelményekkel rendelkező gyártási ágazatok (autóipar, repülőgépipar, orvostechnikai eszközök) körülbelül feleannyi ütemben alkalmazzák a mesterséges intelligenciával hajtott automatizálási eszközöket, mint az általános gyártás és logisztika, elsősorban a minőségirányítási rendszerkövetelmények által támasztott további validációs teher miatt. A jelentés becslése szerint a mesterséges intelligenciával kiegészített programozási eszközök (az itt leírt keretrendszer 1. és 4. rétege) 2028-ra elérik a többségi elterjedést a nem autóipari ipari robotalkalmazásokban, míg a VLA teljes körű bevezetése tanúsított minőségi környezetekben további két-négy évet igényel ezen küszöbértéken túl.
Kockázatok és akadályok
Hallucináció és biztonság: MI által generált veszélyes pályák
Az LLM-ek szintaktikailag érvényes robotprogramokat generálhatnak, amelyek kinematikailag vagy dinamikusan nem biztonságosak. Egy generált útvonal a robot elérhető munkaterületén kívülre helyezheti az effektort, áthaladhat egy szingularitáson, vagy olyan ízületi sebességeket írhat elő, amelyek meghaladják a dinamikus határokat. Ez nem elméleti kockázat – a korai LLM kódgenerálási kísérletekben már megfigyelték, amikor a validációs lépéseket kihagyták vagy lerövidítették. A szükséges enyhítés egy kötelező formális ellenőrzési réteg: az elérhetőségi elemzést, az ütközésérzékelést és a dinamikus határérték-ellenőrzést minden MI által generált útvonalra alkalmazni kell a fizikai vezérlőre való feltöltés előtt. Egyetlen MI kódgeneráló rendszer sem kerülheti meg ezt a réteget, függetlenül attól, hogy mennyire megbízhatónak tűnik a modell kimenete.
A VLA modellek esetében a biztonsági kihívás alapvetőbb. Egy neurális hálózati szabályzat válasza a disztribúción kívüli bemenetekre – egy új objektumgeometria, egy váratlan fényviszonyok, egy részben takart jelenet – szabályosan leromolhat, vagy hirtelen meghibásodhat, és annak előrejelzése, hogy melyik fog bekövetkezni, nem egyszerű a jelenlegi értelmezési eszközökkel. Az ISO 10218-3 szabvány, amely a mesterséges intelligencia által generált robotkódot és a mesterséges intelligencia által vezérelt mozgástervezést fogja lefedni, 2026-tól előzetes fejlesztés alatt áll. Az ideiglenes megközelítés, összhangban a SOTIF (ISO 21448) érvelésével, egy szigorú működési tervezési tartomány meghatározása és a mesterséges intelligencia működésének ezen kívüli korlátozása, amíg további validációs bizonyítékok nem gyűlnek össze.
Költség- és beruházási költségek kiszámítása
A VLA-következtetés futtatásához egy termelési cellában dedikált GPU-számítási csomópontra van szükség. Egy 7B-paraméteres modell (OpenVLA-méretarányú) egyetlen közepes tartományú GPU-n futtatható 6–10 Hz-es következtetési frekvencián; a nagyobb modellekhez több csúcskategóriás GPU szükséges. A VLA-telepítéseket értékelő robotcella-integrátorok iparági megfigyelései szerint egyetlen következtetési csomópont GPU-hardverköltsége körülbelül 4,000–8,000 USD-val növeli a cella beruházási költségeit, ami a jelenlegi hardverárak mellett 5–10%-os prémiumot jelent egy hagyományos robotcellához képest. Ez nagy léptékben kezelhető beruházási többlet, de nem triviális a kis- és közepes gyártók számára, akik cellánkénti alapon értékelik a megtérülést.
IP és adattulajdonlás
Amikor a mesterséges intelligencia rendszerek az ügyfél létesítményeiben generált termelési pályákból tanulnak – akár a gyártó által integrált LLM eszközökön, akár VLA betanítási folyamatokon keresztül –, akkor nem rendeződik a jogi kérdés, hogy kié a kapott modellfejlesztések és betanított súlyok. Az Open X-Embodimement adatkészlet precedenst teremtett az intézmények közötti, akadémiai adatok Creative Commons feltételek szerinti megosztására, de a kereskedelmi termelési adatok más korlátozások alatt működnek. A vevőknek kifejezett szerződéses feltételeket kell követelniük a mesterséges intelligencia robotikai szállítóktól, amelyek kiterjednek az adatmegőrzésre, a modellfejlesztési jogokra és a versenyképes felhasználási korlátozásokra, mielőtt elköteleznék magukat olyan platformok mellett, amelyek az adott létesítményre jellemző pályaadatokból tanulnak.
Szabványügyi hiányosság: Nincs ISO szabvány a mesterséges intelligencia által generált robotkódra
Az ISO 10218-1 és az ISO 10218-2 szabványok szabályozzák a robotok tervezését és integrációjának biztonságát. Az ISO/TS 15066 az együttműködő robotok emberkontaktus biomechanikájával foglalkozik. Ezen szabványok egyike sem foglalkozik konkrétan a mesterséges intelligencia által generált mozgásprogramokkal. Az ISO 10218-3, a javasolt kiterjesztés, amely a mesterséges intelligencia által vezérelt robotvezérlést és kódgenerálást fedné le, 2026-tól előzetes fejlesztés alatt áll. Amíg ez a szabvány nem jelenik meg, a mesterséges intelligencia által generált kódot tanúsított minőségi környezetekben telepítő gyártóknak saját validációs érveket kell kidolgozniuk, és azokat a szabványnak való megfelelés nyilvántartásától elkülönítve kell dokumentálniuk.
Adaptációs keretrendszer: Öt lépés a jelenlegi flottától az AI-kiegészítésig
A gyakorlatban a hagyományosan programozott robotflottáról a mesterséges intelligenciával támogatott gyártásra való áttérés szakaszos utat követ. A VLA telepítésére való közvetlen ugrás a köztes rétegek nélkül validációs adósságot és magasabb hibaszázalékot eredményez, mint a fokozatos bevezetése.
Auditálja a meglévő flottát: mely robotmárkák és vezérlőnyelvek vannak használatban, a programok mekkora arányban vannak manuálisan betanítva az OLP-vel generáltakhoz képest, és mennyi az új alkatrészek átlagos programozási ideje. Ez az alapvonal határozza meg, hogy az 1. rétegbeli LLM kódgenerálás hol hozza a leggyorsabb megtérülést, és mely cellák alkalmasak a 4. rétegbeli mesterséges intelligenciával kiegészített OLP-re. E leltár nélkül az adaptációs döntések inkább feltételezéseken, mint bizonyítékokon alapulnak.
Válasszon ki egy több cellában használt vezérlőnyelvet (a FANUC TP vagy az ABB RAPID a leggyakoribb választás), és futtasson egy 60–90 napos kísérleti programot egy LLM kódkiegészítő eszközzel. Mérje meg a programozási időt előtte és utána, kövesse nyomon a validációs szakaszban észlelt mesterséges intelligencia által generált hibák számát, és dokumentálja az elfogadható kimeneti minőség eléréséhez szükséges készségszintet. A cél egy validált időmegtakarítási adat és egy világos kép arról, hogy hol nem képezheti vita tárgyát az emberi felülvizsgálat.
Nagy mennyiségű alkatrészkeverést igénylő hegesztő- vagy összeszerelő cellák esetén érdemes 3D-s szkennelés-útvonal vagy természetes nyelvű folyamatgeneráló rendszert kiértékelni. Az első darab programozási idejét, a kezelői szakértelemre vonatkozó követelményeket és a hibaszázalékokat az első gyártási sorozatban mérni az OLP alapértékhez képest. Hegesztés esetén a telepítés előtt ellenőrizni kell, hogy a rendszer folyamatkönyvtára tartalmazza-e a releváns kötéstípusokat és anyagokat.
Azonosítson egy vagy két olyan cellajelöltet, ahol az alkatrészválaszték magas (20+ különböző SKU), a tűréshatárok lazák (0.5 mm feletti pozíciópontosság elfogadható), és az alkalmi meghibásodások költsége kezelhető. Készítsen egy demonstrációs adatgyűjtési tervet, jellemzően 100–300 órás teleoperációt a célfeladat-eloszlásban, a modell betanításának megkezdése előtt. Futtassa a VLA réteget a meglévő determinisztikus vezérlő felett; ne cserélje le a biztonsági besorolású mozgásvezérlőt.
A 2–4. lépésekből származó kísérleti eredmények alapján készítsen egy 24 hónapos beruházási tervet, amely számszerűsíti a következőket: a programozási munkaerőköltségek csökkentése (1. és 4. réteg), az átállási idő csökkentése (4. réteg), a GPU cellánkénti beruházási költségei (2. réteg), valamint a VLA gyártáskészségének várható ütemterve az adott alkalmazási vertikálisokhoz a létesítményben. A szabványoknak való megfelelés költségét (mesterséges intelligencia által generált kód ISO 10218 szabvány szerinti validálása) külön tételként, ne utólagos gondolatként tüntesse fel.
Rétegek összehasonlítása: Gyártási készültség, Beszállítók, Költség és Fő Kockázat
| réteg | Készen áll a gyártásra? | Reprezentatív szállítók / platformok | Indikatív költség cellánként | Kulcsfontosságú kockázat |
|---|---|---|---|---|
| 1. réteg: LLM kód és mozgásszkript generálása | Igen – éles környezetben a korai alkalmazóknál; a validációs lépés kötelező | GitHub Copilot (általános), ABB RobotStudio Copilot, FANUC ZDT LLM asszisztens, Microsoft Robotics Copilot (kutatás) | 0–5,000 USD/év (szoftver-előfizetés); hardverbővítés nem szükséges | Nem biztonságos pályagenerálás formális ellenőrző réteg nélkül; még nincs ISO szabvány a mesterséges intelligencia által generált kódra |
| 2. réteg: VLA alapmodellek | Csak elővezérlés – tartálykiválasztás és laza tűrésű összeszerelés; hegesztéshez vagy szűk tűrésű folyamatokhoz nem validált | Kovariant RFM-1, π0 fizikai intelligencia, AI Helix ábra, Google DeepMind Gemini Robotics, NVIDIA GR00T N1 | 4,000–8,000 USD GPU hardver + jelentős adatgyűjtési költség (feladatonként 100–300 óra teleoperáció) | A sztochasztikus következtetés meghaladja a folyamat tűréshatárait; nincs ISO 10218-3 szabvány; magas az adatgyűjtés költsége |
| 3. réteg: Generatív szimuláció | Kísérleti / eszközfejlesztési fázis – VLA betanítási adatok kiegészítésére használják; nem önálló éles rendszer | NVIDIA Cosmos, NVIDIA Isaac Sim 4.5, Genesis (Tsinghua), DreamGen, RoboCasa | 0 USD (nyílt forráskódú) és 50 000 USD+/év (NVIDIA vállalati verzió); a GPU számítási költsége további | A szimuláció és a valóság közötti szakadék továbbra is fennáll; a szintetikus adatok minősége a fizikai pontosságtól függ; a megtérülés a VLA telepítéséhez kötődik, amely továbbra is kísérleti fázisban van |
| 4. réteg: Mesterséges intelligenciával kiterjesztett OLP / Természetes Nyelvű Tanító Pendant | Igen – gyártásban is alkalmazzák szabványos hegesztési geometriákhoz, összeszereléshez és nagy keverésű átállási környezetekhez | ABB RobotStudio + Copilot, FANUC ZDT + LLM asszisztens, EVST EVS-AI hegesztőrendszer (3D szkennelés + automatikus útvonal), Inrotech AdaptiveARC | 40 000–120 000 USD cellánként (hardver + szoftver a teljes 3D szkennelés-útvonalhoz; alacsonyabb, csak LLM integráció) | A folyamatkönyvtár lefedettségi korlátai: az összetett, többrétegű, egzotikus ötvözetekből készült hegesztések továbbra is manuális OLP-t igényelnek; a WPS nyomonkövethetőségi auditkövetelményei növelik az érvényesítési költségeket. |
Gyakran ismételt kérdések
Melyik generatív mesterséges intelligencia réteggel kellene egy gyártónak kezdenie az ipari robotikában?
Az 1. réteg (LLM által támogatott kódgenerálás) a legalacsonyabb kockázatú belépési pont. A meglévő OLP eszközökhöz és vezérlőnyelvekhez csatlakozik a hardver vagy a biztonsági architektúra megváltoztatása nélkül. A robotprogram-készítés során dokumentáltan 25–40%-os időmegtakarítás érhető el a kísérleti telepítések során 30–90 napon belül. A 4. réteg (mesterséges intelligenciával kiegészített tanárpult) a második logikus lépés, különösen a nagy alkatrész-keverékkel rendelkező hegesztő- és összeszerelő műhelyek számára. A VLA kísérleti projekteket (2. réteg) el kell halasztani, amíg az egyszerűbb rétegek stabilak nem lesznek, és amíg megfelelő demonstrációs adatokat – jellemzően 100–300 órányi teleoperációt – nem gyűjtöttek össze.
Hogyan ellenőrzik a gyártók a mesterséges intelligencia által generált robotpályák biztonságosságát?
A jelenlegi bevált gyakorlat szerint az LLM vagy VLA által generált mozgáscélokat egy determinisztikus biztonsági monitorba csomagolják, amely érvényesíti a munkaterület-korlátokat, a sebességkorlátokat, az ízületi nyomatékkorlátokat és az ütközés-elkerülési ellenőrzéseket, függetlenül attól, hogy mit kér az MI réteg. Az ISO 10218-1 és ISO 10218-2 szabványok szabályozzák a robotok tervezését és integrációjának biztonságát; az ISO/TS 15066 a kollaboratív robotok érintkezési erőit tárgyalja. Az ISO 10218-3 szabvány (amely kifejezetten a MI által generált robotkódot tárgyalja) 2026-tól előzetes fejlesztés alatt áll. Amíg ez a szabvány megjelenik, az autóiparból származó SOTIF (ISO 21448) érvelési keretrendszer – amely meghatározza az operatív tervezési tartományt és korlátozza a MI működését azon kívül – egy működőképes validációs megközelítést biztosít.
A mesterséges intelligencia által támogatott kódgenerálás bevezetése OEM-függőséget okoz?
Ez a megvalósítási rétegtől függ. A gyártói OLP eszközökbe (ABB RobotStudio Copilot, FANUC ZDT) integrált LLM asszisztensek OEM-specifikusak: a generált RAPID vagy TP kód hordozható, de maga az AI asszisztens a gyártói platformhoz kötött. A több vezérlőnyelvet célzó nyílt forráskódú és harmadik féltől származó LLM eszközök megkerülik ezt a korlátozást. A VLA alapmodellekhez az NVIDIA GR00T N1 nyílt súlyokat biztosít, míg a Physical Intelligence π0 és a Figure AI Helix saját fejlesztésűek. A vásárlóknak fel kell mérniük a betanított modellsúlyok és a betanítási adatok hordozhatóságát, mielőtt egy zárt platform mellett döntenének.
Mikor lesznek a VLA alapmodellek készen a gyártási hegesztési alkalmazásokra?
A konszenzusos előrejelzés szerint 2026–2028 között korlátozottan kerül sor a szabványos hegesztési geometriák (sarok-, tompa- és átfedő varrat szénacélon vagy alumíniumon) bevezetésére, három fejlesztés függvényében: a VLA következtetési megbízhatósága eléri a 99% feletti üzemidőt több műszakos termelés során; egy ISO szabvány a mesterséges intelligencia által generált robotkódhoz, amelyre a hegesztési minőségbiztosítási keretrendszerek hivatkozhatnak; és megfelelő demonstrációs adatgyűjtő infrastruktúra a létesítmény szintjén. A nehéz geometriájú és egzotikus ötvözetű hegesztés valószínűleg 2028-ig és azon túl is determinisztikus OLP-alapú rendszereken marad.
Ki birtokolja az ügyfél termelési adatain betanított mesterséges intelligencia rendszerek által generált robotpályákat?
Ez 2026-tól kereskedelmileg és jogilag is megoldatlan. Az Open X-Embodimention adatkészlet precedenst teremtett az akadémiai adatmegosztás terén a Creative Commons feltételei szerint, de a kereskedelmi termelési adatok más korlátozások alatt működnek. Amikor a mesterséges intelligencia rendszerek az ügyfelek útvonaladataiból tanulnak, a gyártó és a mesterséges intelligencia szállítója közötti szerződéses feltételek szabályozzák az adatmegőrzést, a modellfejlesztési jogokat és a versenytársak felhasználására vonatkozó korlátozásokat. A vevőknek a szerződés megszűnésekor egyértelmű szerződéses megállapodást kell követelniük az adatok tulajdonjogáról, a modellezési jogokról és az adatok törlésére vonatkozóan, mielőtt bármilyen olyan mesterséges intelligencia platformot telepítenének, amely létesítményspecifikus termelési adatokból tanul.
Kapcsolódó olvasás
- Megtestesült mesterséges intelligencia az ipari robotikában: Hogyan változtatják meg a VLA modellek a robotprogramozást — részletes VLA modellek architektúrája, referenciaértékei és biztonsági validációja
- Megtestesült mesterséges intelligencia adatgyűjtése: Teleoperáció és szimulációtól a valóságig (2026) — a demonstrációs adatinfrastruktúra, amelyre az alapmodellek támaszkodnak
- Robothegesztés Offline programozás, szimuláció és digitális ikermodell (2026) — négyrétegű hegesztőszoftvercsomag, beleértve a mesterséges intelligenciával vezérelt, tanításmentes rendszereket
- Folyamatautomatizálási Rendszer — rendszerintegráció, biztonsági szabványok és üzembe helyezési keretrendszerek
- A legnagyobb kobotgyártók 2026-ban: Összehasonlítás — együttműködő robotgyártói környezet, beleértve a mesterséges intelligencia képességeinek megkülönböztetését
Kimenő hivatkozások:
IFR Világ Robotikai Jelentés 2025 |
Stanford MI Index 2025 |
ISO 10218-2: Robotrendszerek és integráció biztonsága |
NVIDIA Isaac Igen